

博睿数据「博睿学院」系列直播聚焦可观测性场景实战,围绕 Bonree ONE 智能可观测平台,覆盖数据集成治理、AI 运维智能体搭建、算力成本管控、数据库可观测构建四大实战场景。本文基于【AI 运维智能体搭建专题:从零搭建运维智能体】主题直播展开技术详解。Bonree ONE·Sage AI运维智能体工作台不是简单的对话工具,而是一套以“资源编排 + 能力复用”为核心的处理机制——先完成运维经验的标准化封装,再以统一智能体视角支撑日常巡检、诊断与问答,让运维能力可配置、可复用、可调度,进而保障业务系统稳定、高效、持续运行。
本期直播完整演示了如何构建一个“数据库调用巡检专家”智能体,并用它完成了一次真实的数据库调用巡检分析。可以直观看到运维智能体如何从资源就绪、能力编排、发布上架,最终在Bonree ONE·Sage AI中被业务侧调用;运维经验如何从个人能力,变成可配置、可复用的组织能力。
企业运维的核心痛点:问题不在“工具少不少”,而在“经验能不能复用”
企业运维工作天然具备经验依赖特征:资深工程师的巡检直觉、故障判断、SQL 分析能力,往往难以标准化传递。各团队独立演进,采用互不统一的巡检流程、阈值标准与报告格式。
工程落地中的核心瓶颈并非工具覆盖不足,而是三类结构性矛盾:
能力不统一:同一类巡检任务,不同人执行的质量参差不齐,报告结构五花八门。
经验不沉淀:资深 DBA 离职,带走了多年积累的巡检经验和判断逻辑。
响应不及时:故障常发生在非工作时间,人工响应窗口极为有限。
正因如此,若缺少专门的智能体搭建机制,运维规模越大,能力缺口、质量波动、响应延迟等问题会持续累积。
四层能力流转架构:构建层、资产层、消费层、运营治理层
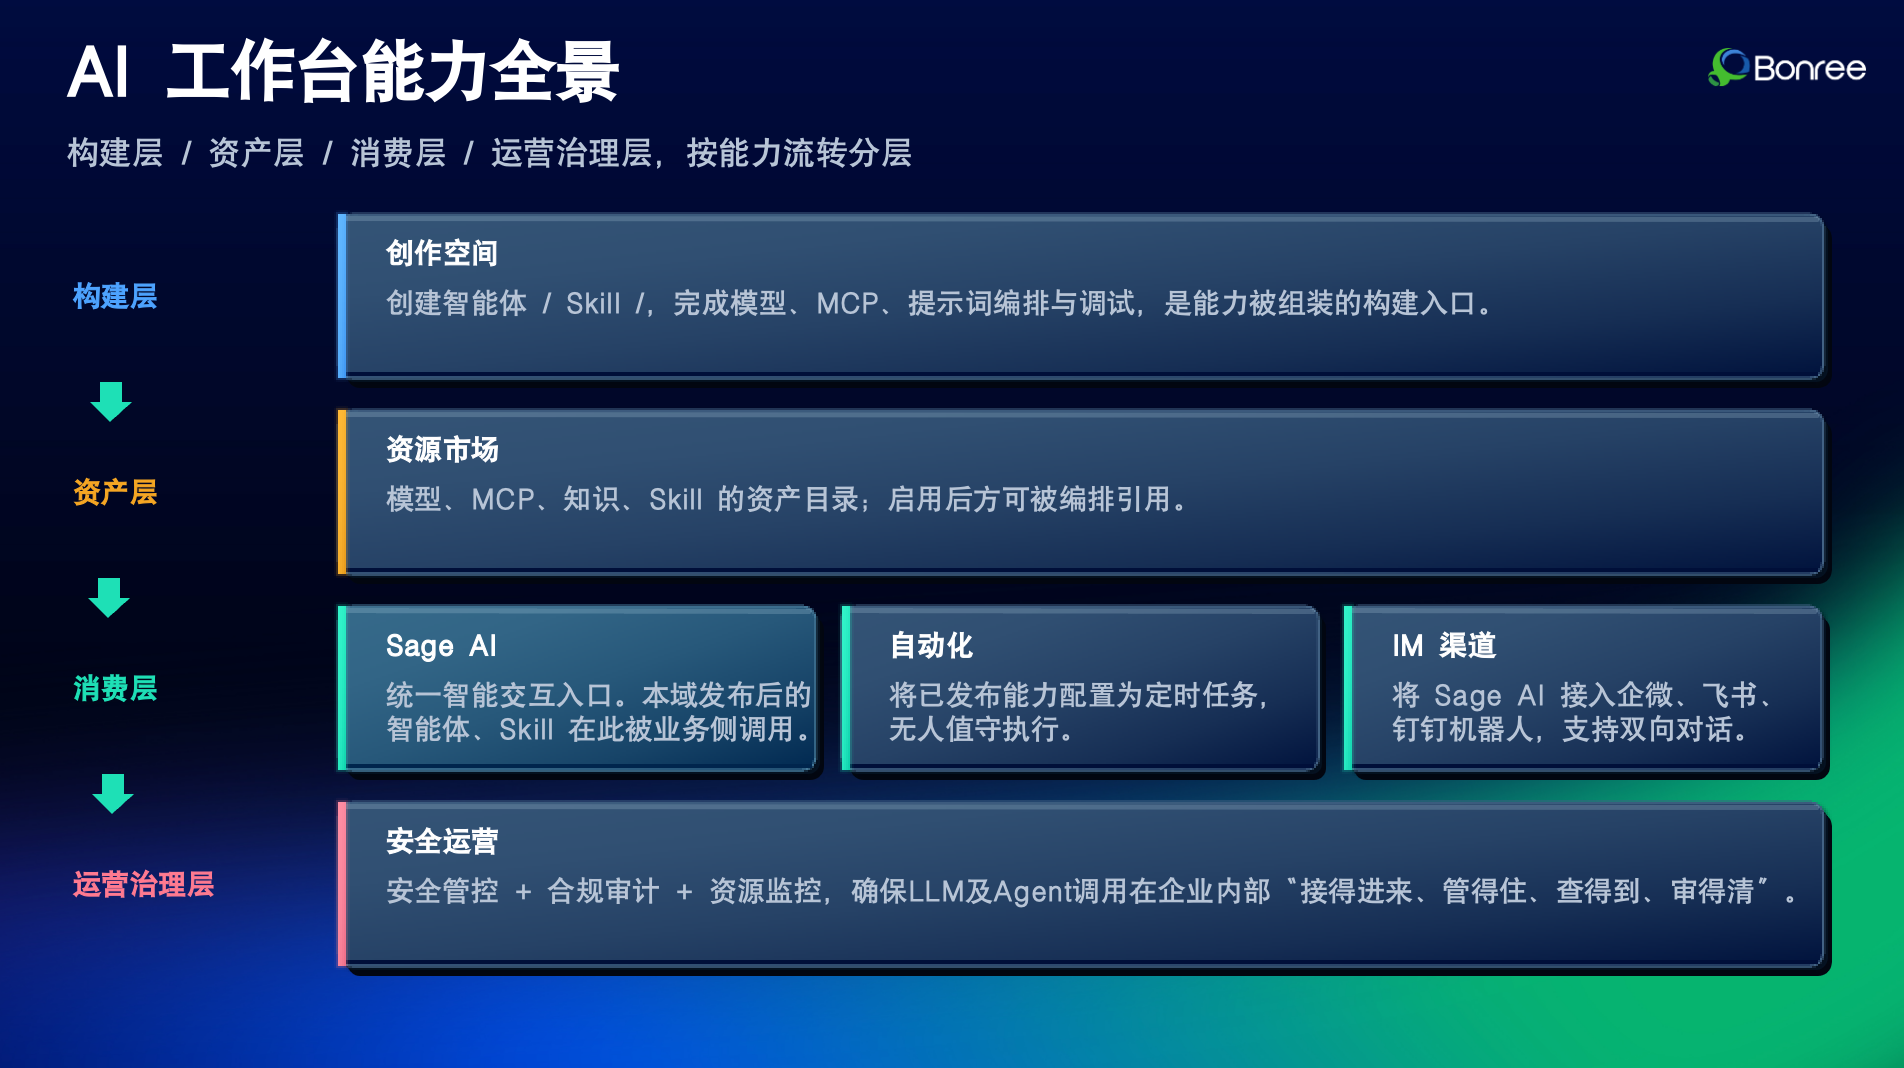
Bonree ONE · Sage AI 智能体工作台提供四层能力流转架构,各层适配不同的能力生产与消费阶段。
一、构建层面向开发者,是“创作空间”。开发者在这里创建智能体和 Skill,完成模型、MCP、提示词的编排与调试。这是能力被组装起来的入口。
二、资产层是“资源市场”。MCP、知识、Skill、智能体的资产目录。资源在构建层被创建后,上架到资源市场,才能被其他角色发现和引用。
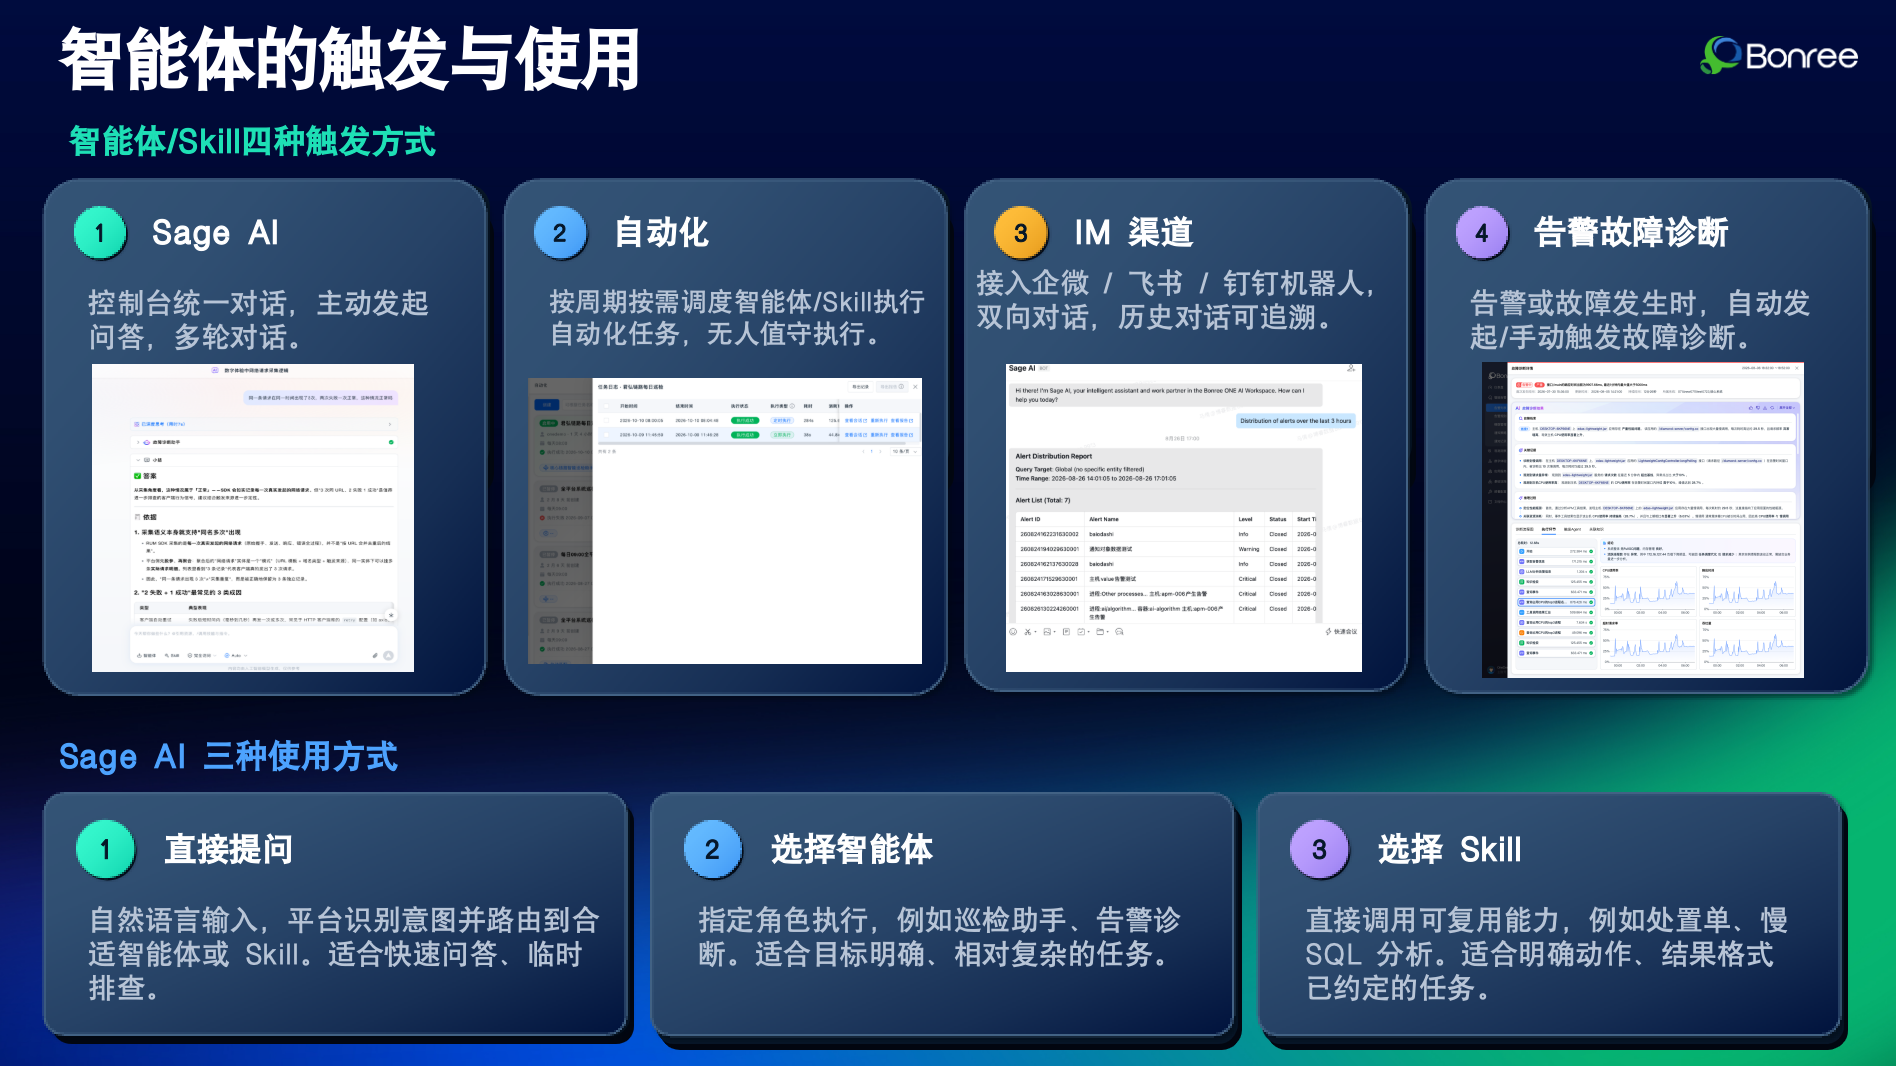
三、消费层包含四个入口:Bonree ONE·Sage AI(统一智能交互入口)、自动化(定时任务调度)、IM 渠道(企微、飞书、钉钉机器人)、告警列表(诊断入口)。已发布的智能体在这里被业务侧调用。
四、运营治理层负责安全管控、合规审计、资源监控,确保 LLM 和 Agent 的调用在企业内部“接得进来、管得住、查得到、审得清”。
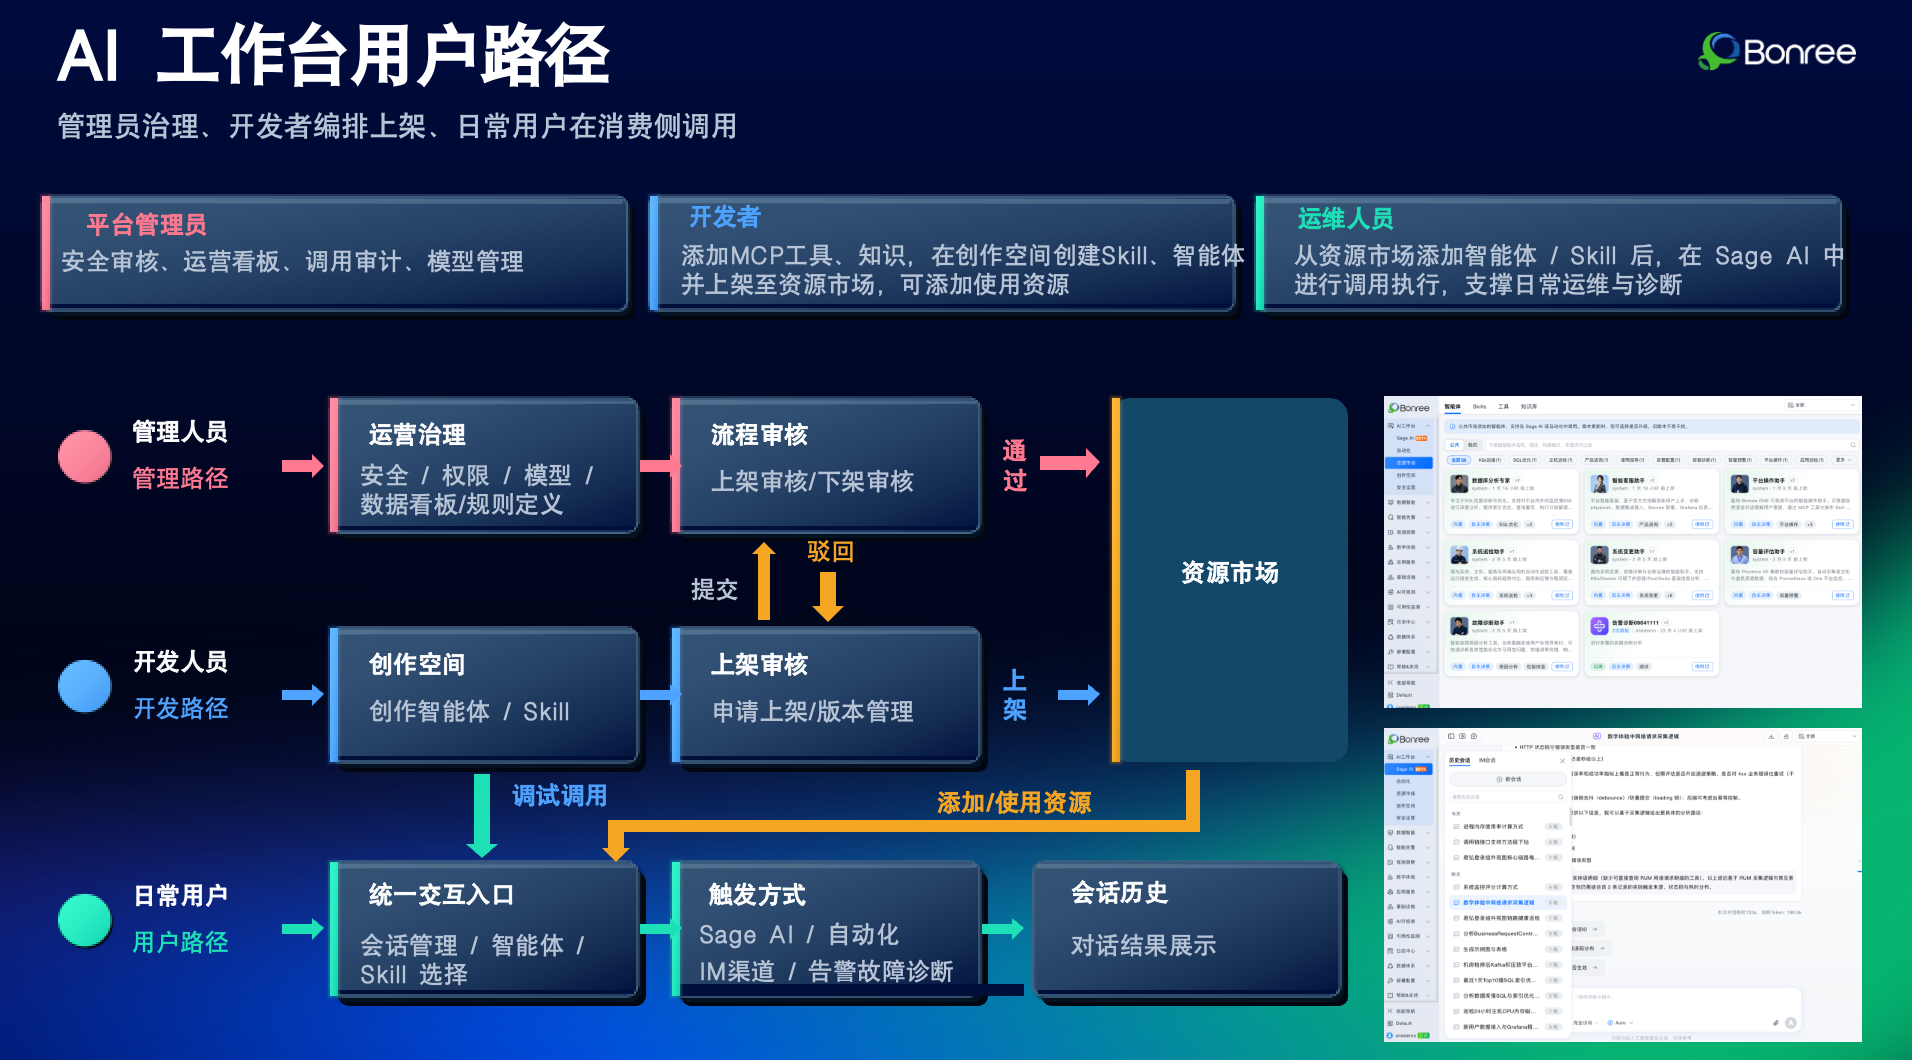
开发者依靠创作空间完成能力孵化;运维人员依靠资源市场获取成品;管理者依靠运营治理层实现安全合规。三类角色各司其职,最终统一汇入同一套智能体消费体系。
智能体搭建核心机制:以资源编排替代简单问答
Bonree ONE·Sage AI智能体搭建区别于简单的对话机器人,核心是在对话之外完成资源编排与能力封装。具体来说,有三个关键能力需要理解:
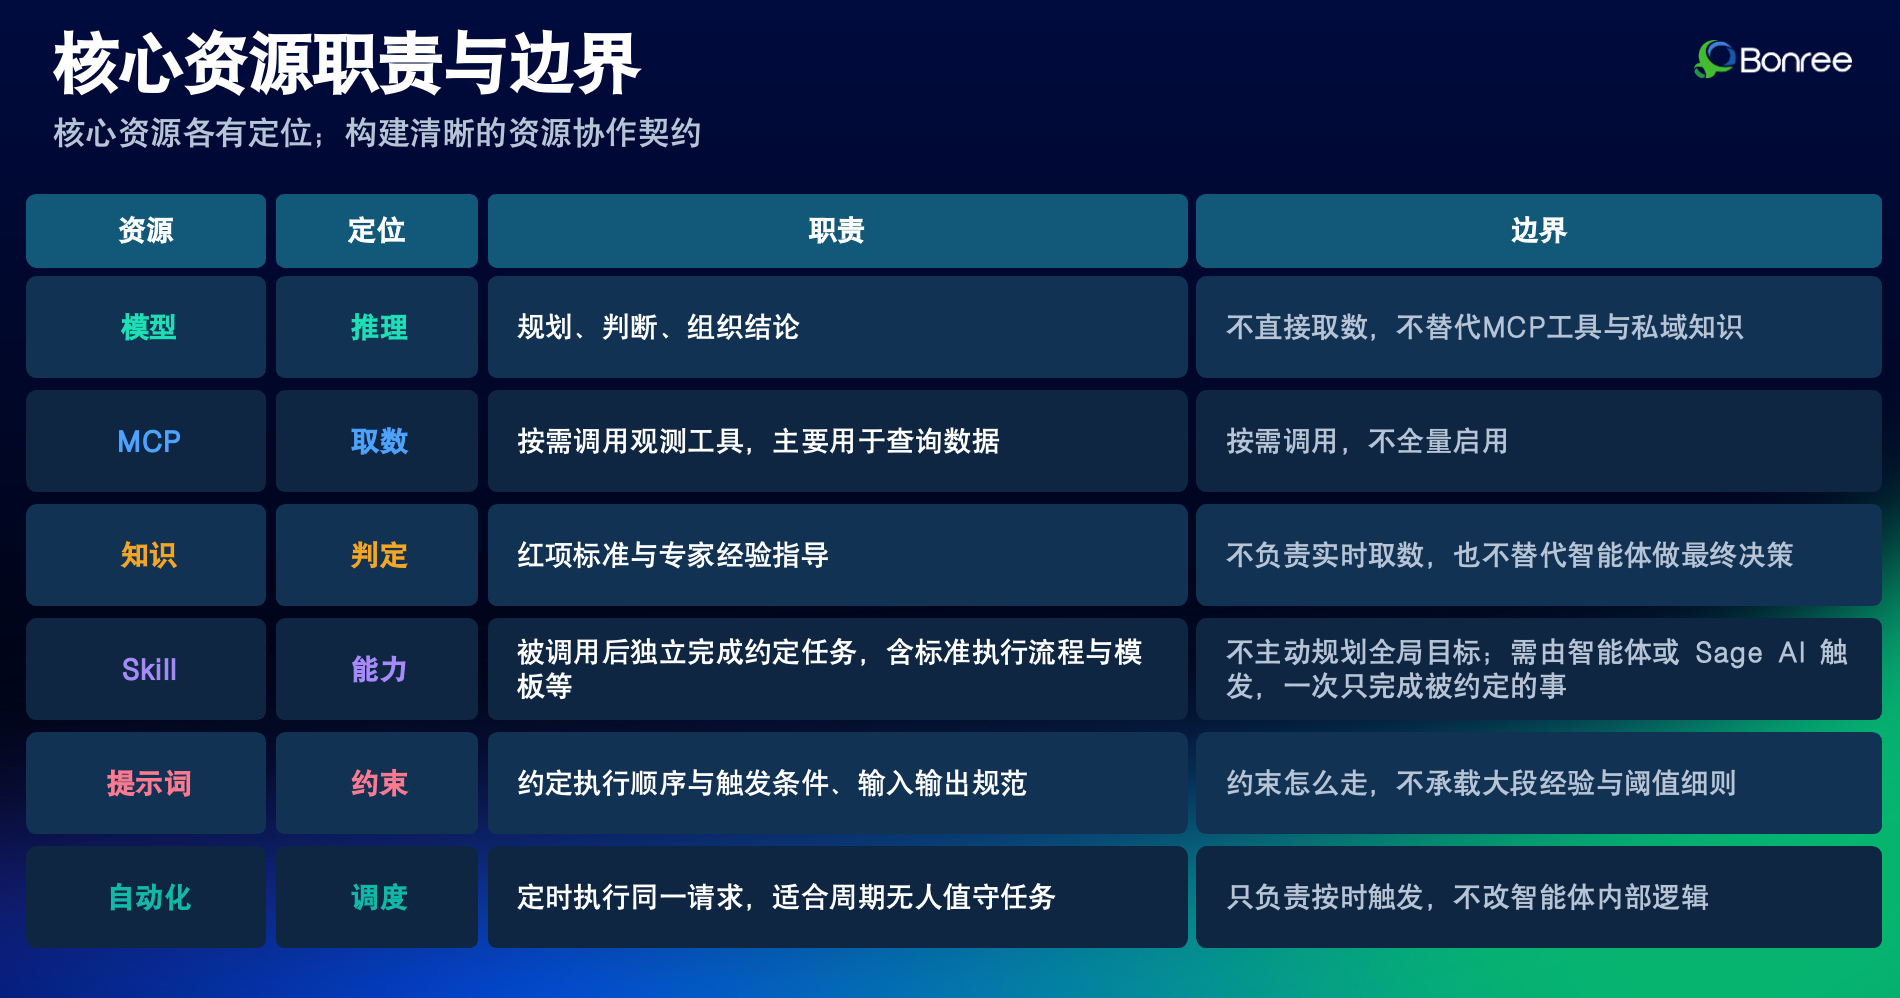
一是资源职责与边界划分。
模型负责推理规划,不直接取数;MCP 负责按需取数;知识提供判定标准;Skill 作为执行单元独立完成任务;提示词约束执行顺序与触发条件;自动化负责定时调度。每个资源各司其职,构建清晰的资源协作契约。
二是智能体与 Skill 的协作关系。
智能体像餐厅店长,负责规划与调度,判断当前该取数、查知识,还是调用某个 Skill;Skill 像一道菜的标准工艺,被点到才做,按菜谱完成并按规定摆盘。店长根据需求先规划,需要时才调用对应 Skill,Skill 完成后将结果交回智能体继续决策。
三是两种智能体类型。
工作流按既定节点推进,适合路径稳定、步骤明确、需要强管控的流程;自主决策由模型规划路径并调度资源,适合路径不固定的复杂场景。两条路径覆盖企业两类典型任务形态,最终统一在Bonree ONE·Sage AI中被调用。
实战演示:数据库调用巡检专家的创作与调用
本次实操演示的场景,是构建一个“数据库调用巡检专家”智能体。巡检工作流采用五阶段递进式框架:确认巡检对象与时间范围、盘点可用数据、依次执行五项检查、按影响程度排序、输出巡检报告。每项检查都有明确的口径和阈值参考。
在Bonree ONE·Sage AI的创作空间中,开发者依次完成模型就绪、知识与 Skill 准备、智能体创建、能力编排、发布与调用。整个流程可概括为四个阶段:资源就绪 → 能力编排 → 本域发布后上架 → 在线调用。
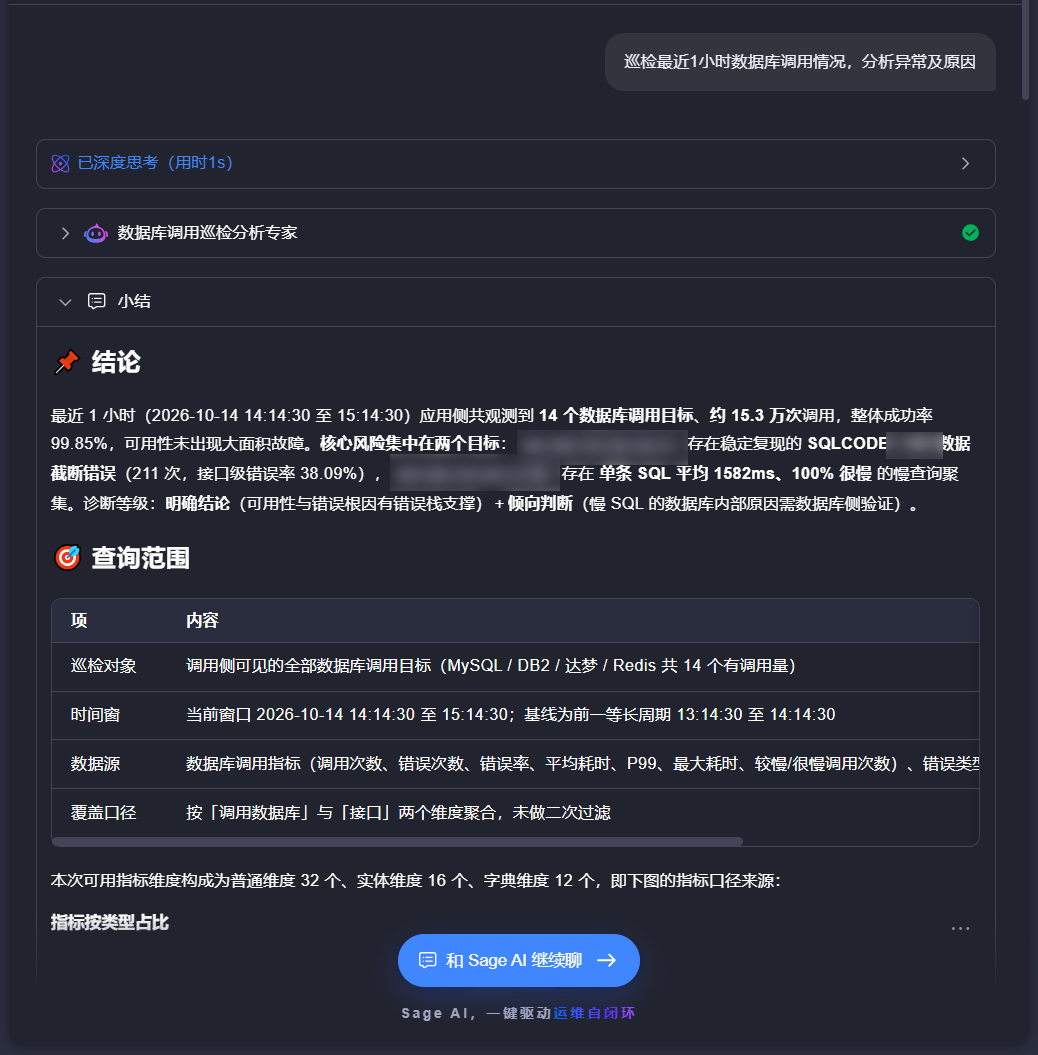
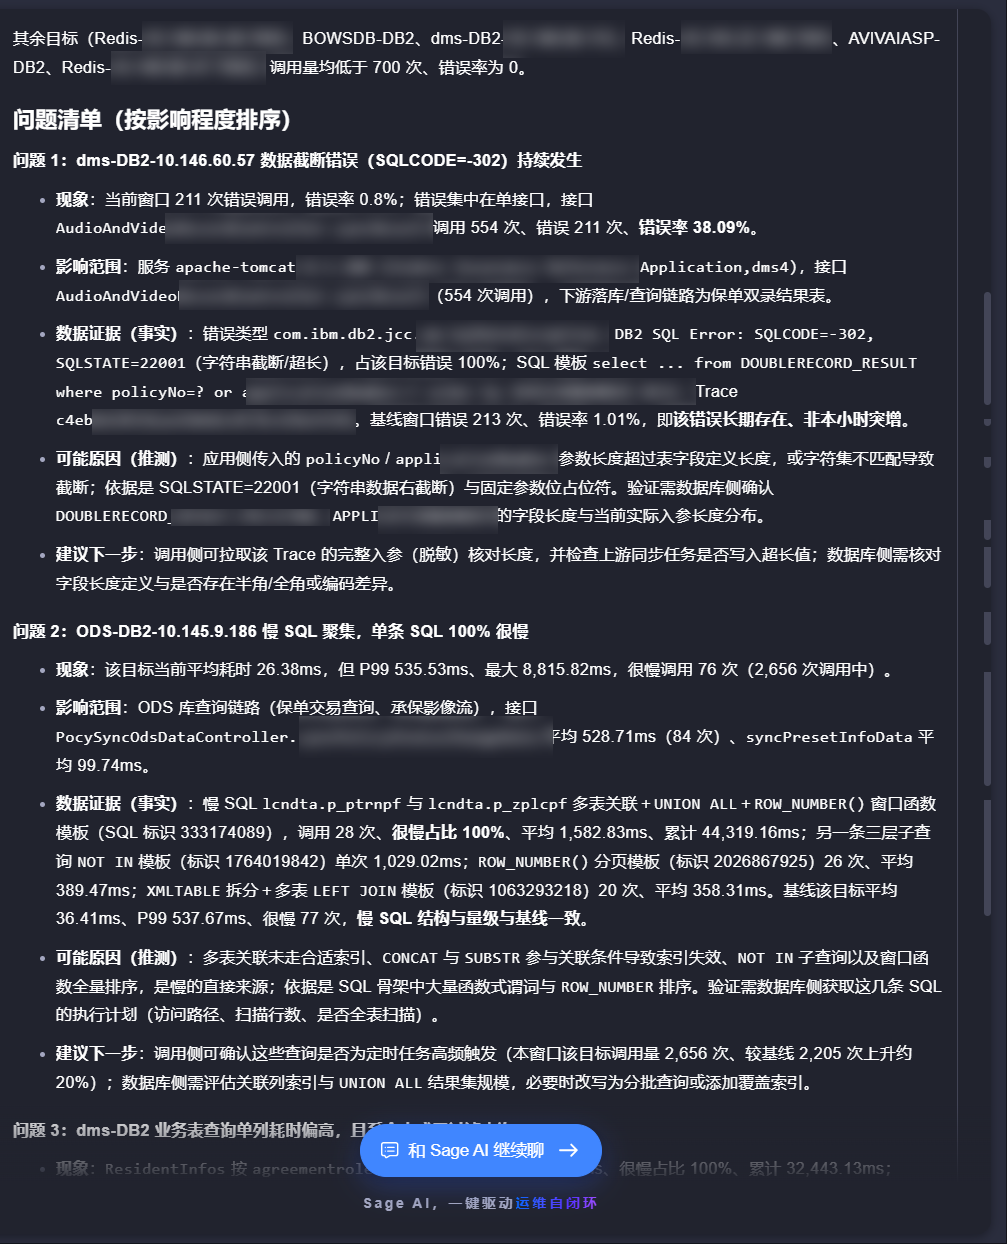
实际调用时,任务描述非常简洁:“巡检最近 1 小时数据库调用情况,分析异常及原因。”智能体按照预设的五阶段工作流,自动完成巡检对象确认、数据盘点、五项检查、影响排序和报告输出。整个分析过程在 4 分钟内完成,覆盖了 14 个有调用量的数据库目标,快速定位到两个关键风险点。
第一个是严重级别问题:某 DB2 数据库存在稳定复现的数据截断错误,接口级错误率达到 38.09%,共发生 211 次,影响范围集中在特定接口。智能体推测根因是应用写入数据长度超出表列定义,或近期数据模型变更未同步适配,并分别给出调用侧与数据库侧的处置建议——调用侧定位触发接口与 SQL 模板、核对传入参数长度,数据库侧确认目标表列定义是否近期变更。
第二个是警告级别问题:某 ODS 数据库存在慢查询聚集,单条 SQL 平均耗时 1582ms,P99 达到 535.53ms,最大耗时高达 8815.82ms。智能体推测根因是索引缺失、统计信息过期或资源争用,同样给出了两侧协同的处置方案——调用侧分析慢 SQL 模板查询模式,数据库侧检查索引使用情况、统计信息更新时间及锁等待情况。
报告同时明确标注诊断等级为:明确结论(可用性与错误根因有错误栈支撑)+倾向判断(慢 SQL 的数据库内部原因需数据库侧进一步验证)。每个问题都严格区分“已证实事实”与“推测”,并分别给出“调用侧可继续验证”与“需数据库侧数据验证”的下一步动作。报告末尾还列出了数据缺口与风险提示,坦诚说明本次结论仅基于调用侧数据的局限。
过去需要资深 DBA 数小时才能完成的巡检比对、问题定位与报告整理,现在只需一句话,智能体在 4 分钟内就给出了包含影响等级分类、现象描述、影响范围、数据证据、可能原因和处置方案的结构化、标准化、可追溯的完整分析结果。
价值递进:从个人经验到组织能力
Bonree ONE·Sage AI 的价值,不在于它多了一个对话入口,而在于它改变了运维能力的生产方式。过去,运维能力附着在具体的人身上;现在,能力可以被拆解、配置、发布和调用。这个变化带来三个层面的递进:
第一,从“经验随人走”到“经验可沉淀”。 资深工程师的巡检逻辑、判断标准、输出规范,被固化到智能体的提示词、知识文档和 Skill 中,不再因为人员流动而流失。一个团队积累的运维经验,第一次有了不依赖个人的承载方式。
第二,从“一次性的分析”到“可复用的能力”。 一次搭建完成的巡检智能体,可以被团队成员反复调用,也可以被其他场景复用,不需要每次都从头开始。能力生产从手工作坊变成了标准化流水线,边际成本大幅降低。
第三,从“被动响应”到“主动覆盖”。 智能体可以按需触发,也可以定时调度,7×24 小时在线。故障发生时,诊断入口随时可用;日常巡检中,覆盖面不再受人力限制。人负责决策和兜底,重复性工作交给智能体。
最终,这些变化指向同一个结果:运维团队的能力上限,不再由人数决定,而是由可配置、可复用、可调度的智能体资产决定。从构建到消费,从资源到资产,从个人经验到组织能力——Bonree ONE·Sage AI 让每个企业都能沉淀出自己的运维专家团队。
点击扫描二维码,即刻下载精彩演讲资料。