

从业务链路编排、运行态观测到 AI 辅助诊断,沿着一笔交易找到值得优先排查的异常环节。
一笔交易从下单、库存校验到支付完成,往往要跨过多个服务和接口。某个节点变慢、一次接口报错,最终都可能表现为同一个业务现象:支付成功率下降。业务负责人想先知道受影响的是哪些交易,排查人员则要回答异常发生在哪段调用、是否与近期链路变化有关。
这些问题无法只靠一张指标看板回答。业务指标呈现了结果,服务指标描述了局部状态,告警提示了异常时间,调用链记录了请求经过的路径。只有把它们放回同一条业务链路,团队才有机会从“发现异常”走向“解释异常”。博睿数据【业务链路观测:构建全链路实时运行态视野】主题直播,正是围绕这一过程展开,以下为技术长文详解。
业务链路越复杂,
越需要一张共同的运行态视图
在日常运维中,团队通常不缺监控数据,真正困难的是把数据对齐到具体业务。一次支付失败可能涉及入口服务、订单服务、支付服务、库存服务和数据库;仅查看某个服务的错误率,难以判断它是问题起点,还是上游失败传递后的结果。
因此,排查首先要回答三类问题:第一,业务影响范围有多大,支付成功率、交易量和订单完成率是否同步变化;第二,异常位于哪条调用分支,哪些节点的错误率或响应时间先发生变化;第三,链路结构近期是否出现新增节点、关系变化或接口调整。问题顺序明确后,团队才能避免在大量看似异常的信号之间来回跳转。
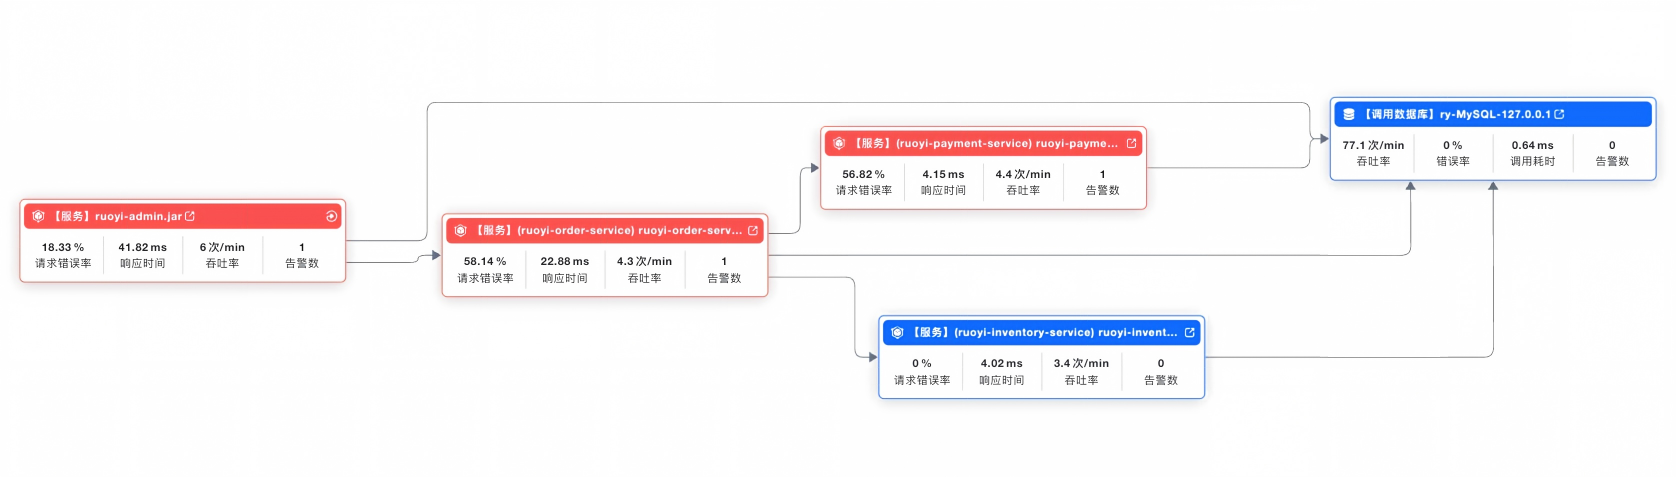
下单、支付与库存服务的调用关系
业务指标与调用性能同屏
才能判断异常意味着什么
一条链路是否健康,不能只看服务是否存活。支付成功率下降时,如果交易量也明显波动,业务影响的解释可能不同;如果订单完成率同步走低,则需要进一步判断失败是否已经扩散到交易闭环。业务指标帮助团队看清结果,性能指标则帮助团队沿调用路径查找原因。
在同一运行态视野中,支付成功率、交易量和订单完成率可以与响应时间、错误率、吞吐率及告警状态一起观察。前者回答“用户交易是否受到影响”,后者回答“哪一段调用变慢、失败增多或承受了流量变化”。当异常信号落到具体节点,排查范围就能从整条链路收敛到需要优先检查的分支。
这种观察方式也为恢复验证提供了依据。修复某个服务后,团队仍需回到业务指标,确认支付成功率等结果指标恢复,再结合节点错误率和响应时间的变化,判断问题是否真正解除。
AI 加入排查:把分散信号整理成可核验的线索
面对多节点、多指标同时告警的场景,排查人员最需要的往往不是更多图表,而是一份说明“先看哪里、为什么先看”的线索。Bonree ONE 的Sage AI 智能分析以业务链路为范围,汇总异常实体、关键指标、告警事件和上下游关系,形成诊断结论、推理过程及优先排查方向。
AI 的作用是帮助整理证据和安排排查顺序。告警与指标可以说明异常何时出现、集中在哪里;日志和调用链用于核验具体请求及异常原因。对于尚未得到原始数据支持的判断,应继续验证,不能直接写成已经确认的根因。
从发现异常到验证恢复,让每一步都回到业务
第一步:确认影响。先查看支付成功率、订单完成率和交易量等业务信号,明确异常是否影响用户完成交易,并圈定受影响的时间范围。
第二步:沿链路收敛。结合告警、节点错误率、响应时间及调用关系,识别异常集中在哪一段路径,区分主要异常节点与可能受到连带影响的上下游节点。
第三步:下钻验证。按照 AI 给出的线索检查异常堆栈、日志和调用链,核对具体接口、请求与错误表现,逐步确认问题原因。
第四步:回看业务恢复。处置完成后,重新检查关键业务指标和链路节点状态。只有业务结果与技术信号都恢复到合理范围,排查才真正形成闭环。
价值递进:从看见服务,到掌握业务运行态
业务影响看得清:以支付成功率等结果指标为入口,团队能先判断异常是否影响真实交易,再把受影响的业务范围与技术事件关联起来。对于业务负责人,沟通不再停留在“某个服务报错”,而能进一步说明用户流程受到了什么影响。
排查路径更聚焦:链路把分散的服务、接口和上下游关系串起来;指标与告警指出异常发生的时间和节点;AI 则帮助汇总线索、建议检查顺序。排查人员可以先验证最有证据支撑的分支,再逐步扩大范围。
处置结果可复核:从异常发现到日志与调用链核验,再到业务指标恢复,每一步都有对应的数据依据。团队在协作和复盘时,可以还原当时为什么判断某个节点更值得优先检查,以及处置后业务是否真正恢复。
让业务视角成为可观测性的共同起点。
业务链路观测的意义,不只是把服务连成一张图。它让业务影响有可追踪的路径,让技术异常有明确的业务语境,也让 AI 分析能够基于链路、指标与告警给出可核验的排查方向。对业务团队而言,能更快了解哪些交易受到影响;对技术团队而言,能按链路优先级组织排查,并用数据验证处置效果。
Bonree ONE 将链路编排、运行态观测与 AI 辅助分析放在同一场景中,帮助团队围绕同一个问题进行写作,达到快速定位,排障及时的目标。
扫描二维码,即刻下载精彩演讲资料。