


从一次用户提问出发,沿调用链看清执行过程,用性能、Token 与运行数据解释 AI 应用的真实状态。
设想这样一个场景:用户问 AI 助手“我的订单什么时候送达?”,等待十多秒后,得到一句“预计明天送达”。但订单系统中的实际状态并不支持这个回答。对用户来说,这是一次又慢又不准的体验;对研发与运维团队来说,问题才刚刚开始:时间耗在模型推理、知识检索,还是工具调用?错误答案来自模型本身,还是下游数据未及时返回?这次请求又消耗了多少 Token?
传统监控能告诉我们服务是否报错、接口是否变慢,却很难直接解释一次 AI 对话。因为用户看到的是一句回答,系统内部经历的却可能是 Agent 编排、模型调用、检索、工具执行与多次重试。要真正管理 AI 应用,就要把用户体验、内部执行和资源消耗放到同一条可追踪的路径上。
从一句回答,追到每一步执行
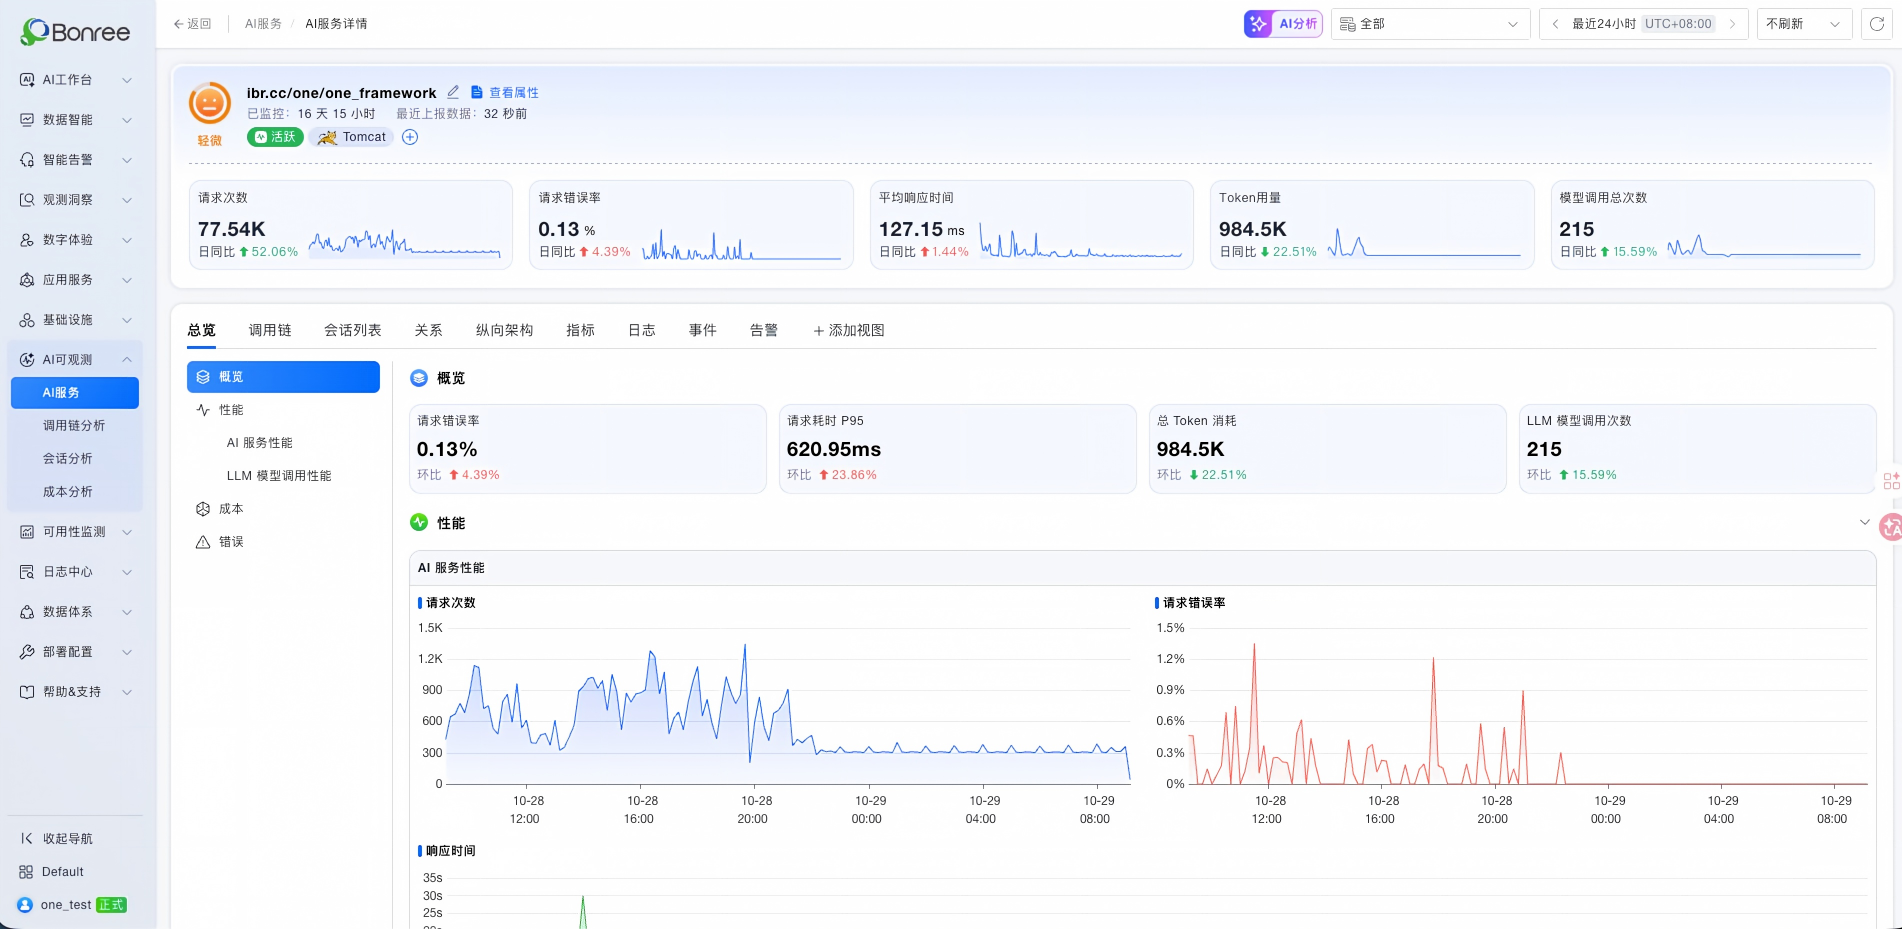
排查的起点不是先猜模型出了什么问题,而是找到用户的那次请求。Bonree ONE 的 AI 可观测能力以调用链还原请求路径:一次对话如何进入 AI 服务,Agent 调用了哪个模型、触发了哪些工具、访问了什么下游,每一步都可以在 Trace 中对应到具体 Span。
打开异常 Span,研发人员可以继续查看父子关系、起止时间、耗时、状态、调用属性,以及错误信息、堆栈和关联日志。这样,排查不再停留在“AI 回答慢”,而能逐步收敛到“哪一个环节慢、何时开始慢、是否伴随错误或重试”。如果多个节点并行执行,还应按端到端关键路径判断耗时,不能把各节点时间简单相加。
对于回答错误的情况,同一条路径也能帮助团队区分线索:模型是否基于过期上下文作答?工具调用是否失败?下游接口是否返回了异常数据?调用链提供过程,日志和错误现场用于进一步核验。只有证据对齐,才能把“猜测”变成可处理的问题。
性能分析:平均值之外,更要看长尾
AI 应用的性能不能只看一个平均响应时间。某些请求可能很快,另一些却因检索、模型推理或工具等待拖成了长尾。Bonree ONE 将请求次数、错误率、响应时间等服务指标与调用链联看,帮助团队先确定异常时间窗,再打开慢请求,逐段比较模型、工具和下游请求的耗时。
如果同一时间错误率与重试次数上升,耗时增加可能只是表象;重复调用还会带来额外 Token 消耗。反过来,某次模型推理变慢,也不一定意味着整条链路都需要优化。把耗时落到具体 Span,团队才能决定是优化提示词、调整模型与参数、治理工具接口,还是检查运行资源。
Token 与成本:看见“花在哪”,才谈得上优化
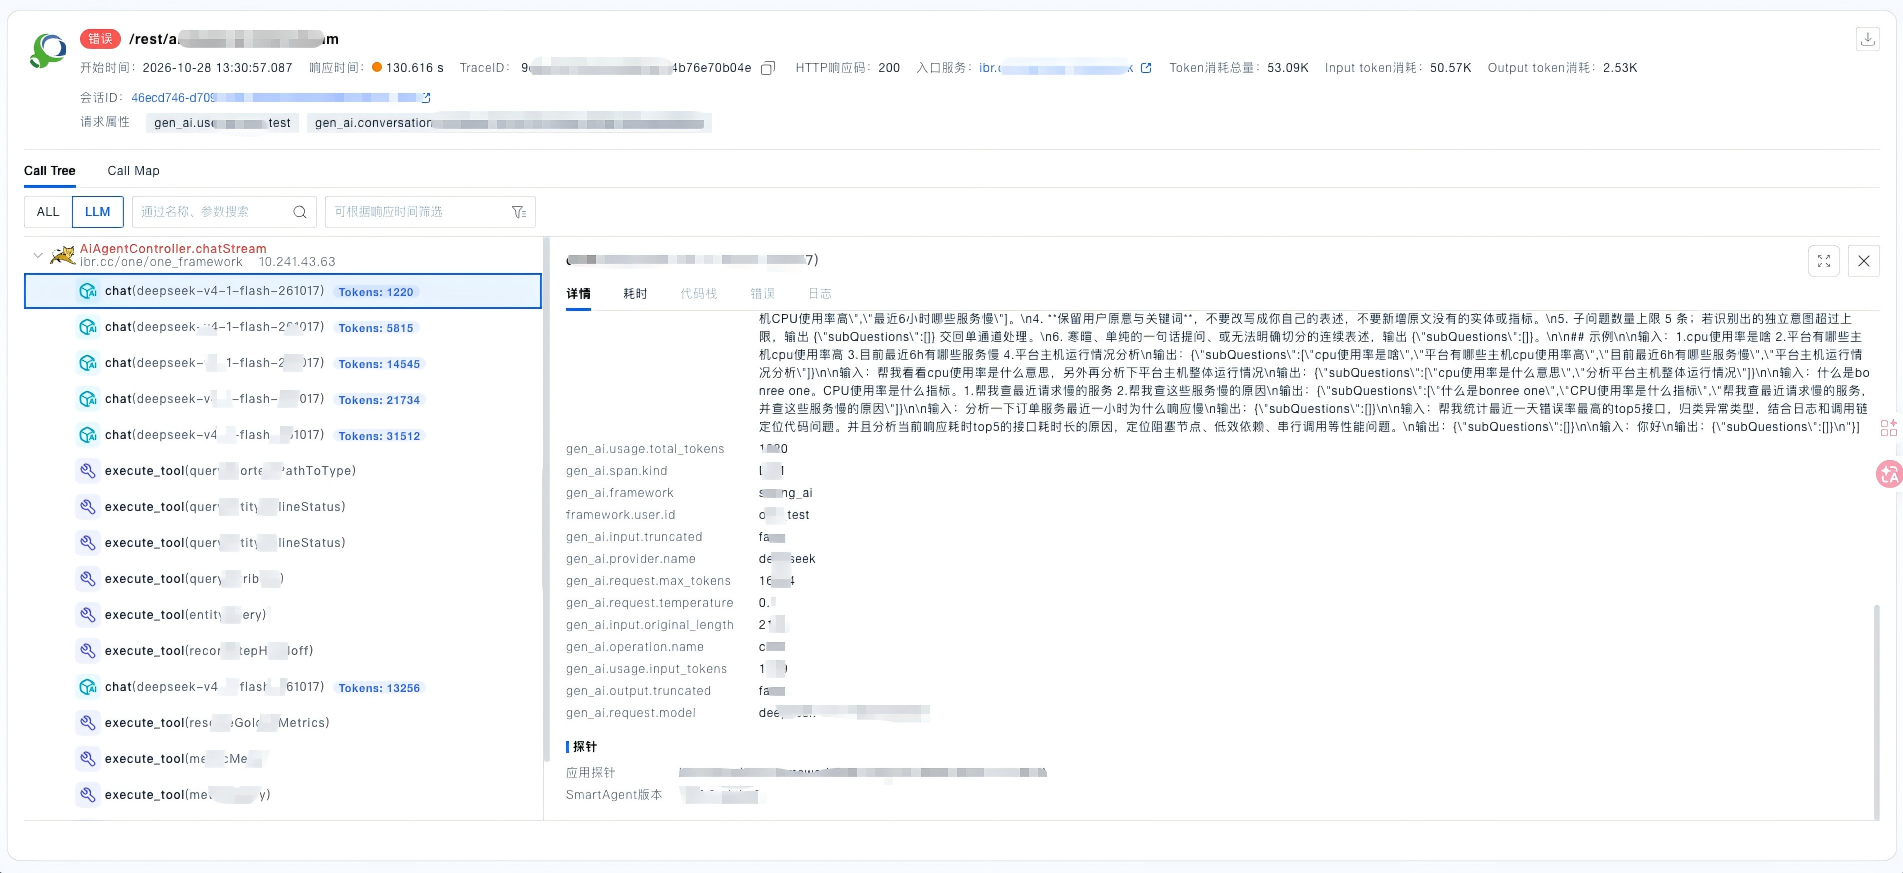
AI 服务的成本会随着调用量、输入长度、输出长度和模型选择一起变化。只看总 Token,能知道用量上涨,却未必知道上涨是否合理。Bonree ONE 将输入、输出与总 Token 分开统计,并按服务、模型和时间趋势查看消耗结构,为费用估算和成本归因提供依据。
例如,同样是 Token 增长,原因可能完全不同:新业务带来更多有效请求;提示词或上下文越来越长;某类任务选用了更昂贵的模型;失败重试让一次问题被多次执行。前一种增长可能对应业务使用扩大,后几种则需要进一步检查效率。把 Token 变化与请求量、错误率、会话和模型分布对齐,才能判断成本增长背后的真实原因。
成本治理也不等于一味压缩用量。对需要较长上下文或复杂推理的任务,过度削减输入可能损害回答质量。更稳妥的做法,是先识别高消耗的服务、模型和会话,再结合体验与准确性调整策略,让每一笔消耗都能对应到可解释的任务价值。
同一套数据,回答不同角色的问题
管理者关心的是所辖智能体是否真正被使用、消耗增长来自哪里、运行是否稳定。按智能体汇总调用次数、活跃趋势、Token 与费用估算,再下钻模型和会话,才能把“预算变化”与“业务使用”联系起来,而不是只得到一张总量报表。
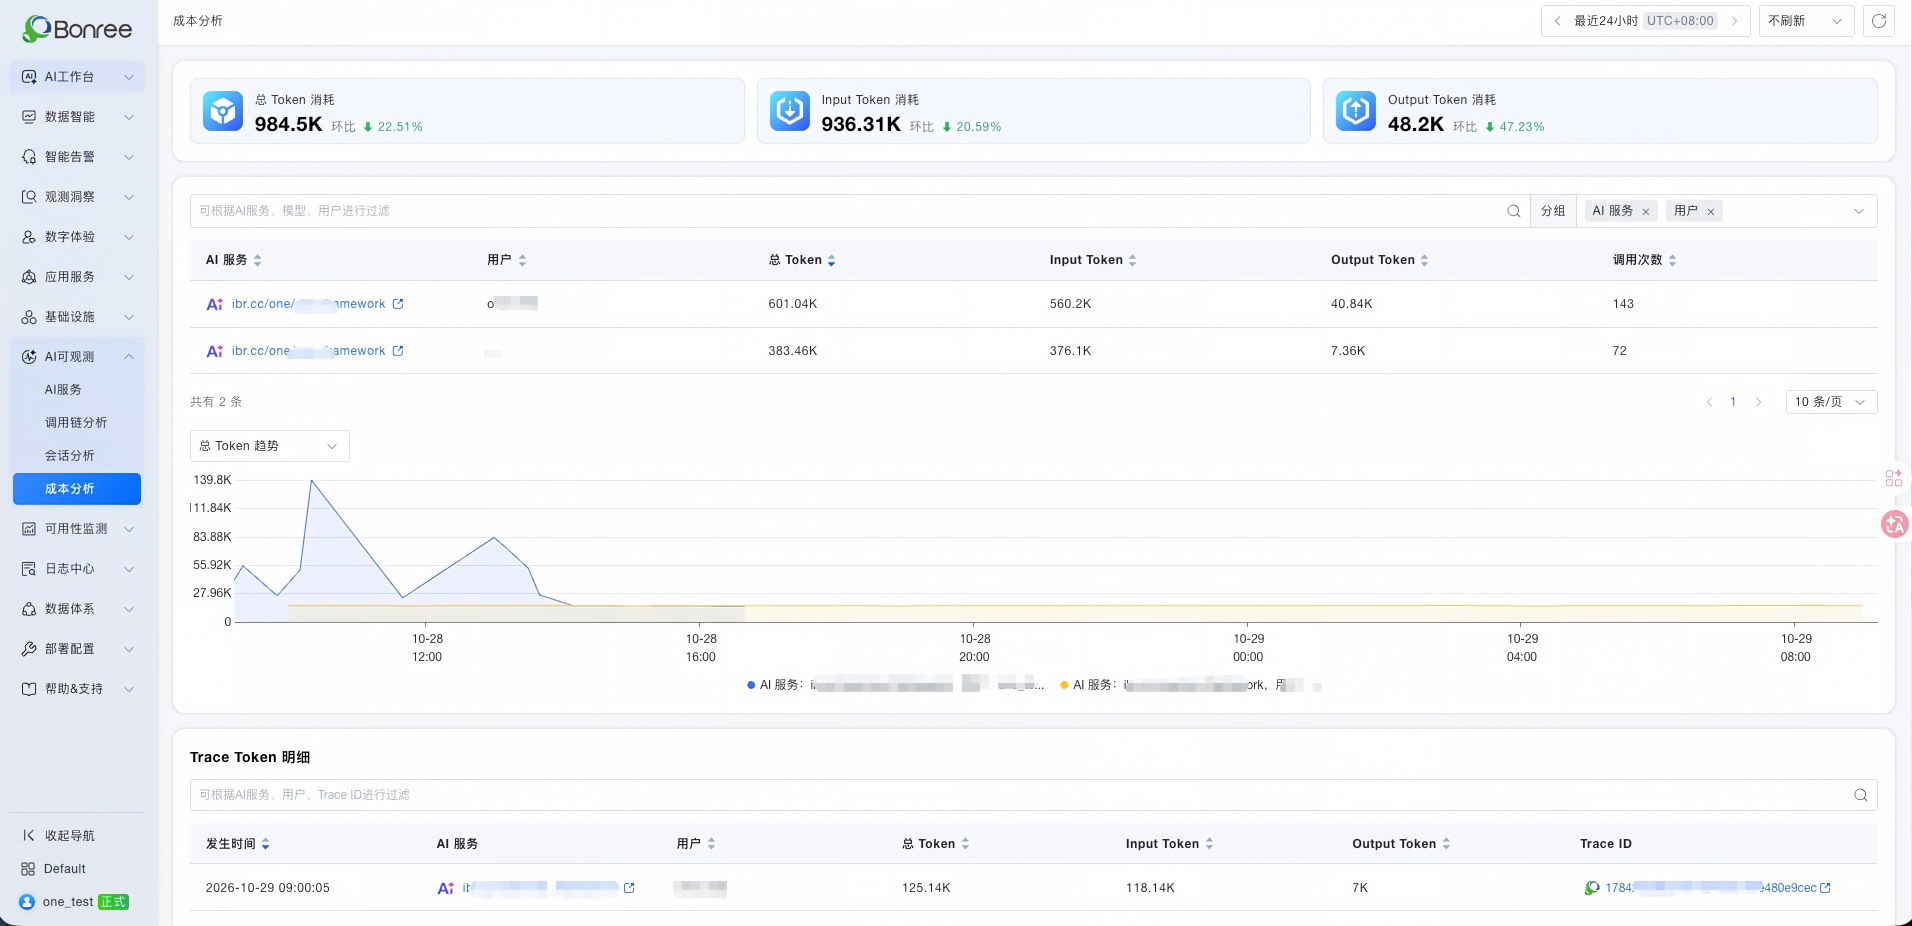
研发与运维团队则需要走得更深:从异常时间段进入具体 Trace,查看 Span 的耗时、错误和堆栈;再沿上下游关系了解流量来源和依赖影响,结合日志、事件与告警交叉核实。AI 服务所在的容器或主机状态也应纳入视野,CPU、内存、磁盘等资源变化可能与响应波动有关;算力相关指标则需要完成相应集成后查看。
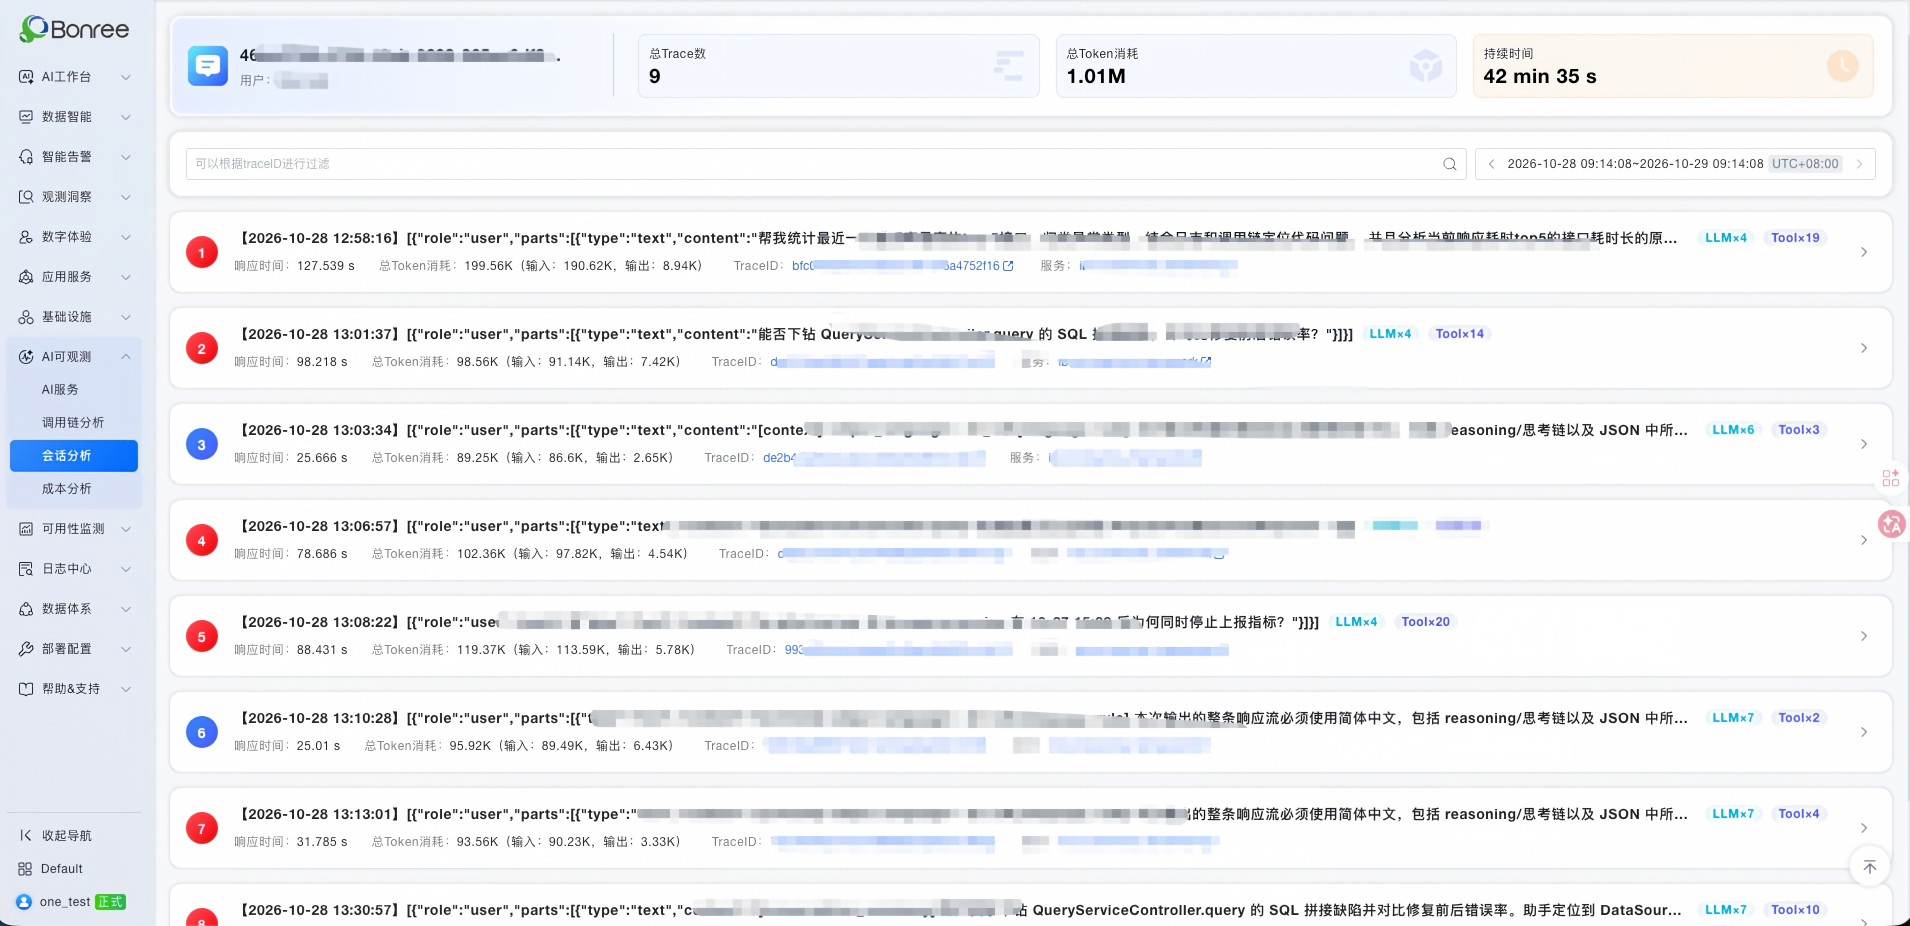
会话分析补上了另一个视角:同一类用户意图是否反复失败,哪些对话出现质量问题,异常是否集中在某个模型、工具或任务类型。它帮助团队从单次故障走向持续改进,而不只是“这次修好了”。
让一次排障,形成可复核的闭环
实际处理 AI 应用异常时,可以沿着一条清晰的路径推进:先从用户反馈、错误率、响应时间或会话质量确认问题;再进入调用链,找出耗时与错误最集中的环节;随后结合 Span、日志、事件和运行资源验证原因;完成调整后,回到用户体验、性能和 Token 趋势,观察问题是否真正缓解。
这一闭环的价值在于,让不同团队说的是同一件事。业务方能理解用户受到了什么影响,研发人员能看到具体失败节点,管理者能解释成本和使用变化。数据不再是散落在不同看板里的数字,而是围绕一次 AI 请求串起来的证据链。
AI 应用走向生产,首先要看得见
从模型调用延伸到会话、工具、依赖和运行资源,AI 可观测性要回答的始终是几个具体问题:用户经历了什么?系统实际做了什么?时间和成本花在了哪里?问题影响了谁,又该从哪一步开始处理?
Bonree ONE 通过实体与指标模型组织 AI 服务及上下游关系,把调用链、性能、Token 消耗、会话与异常证据连接起来,帮助团队持续理解 AI 应用的运行状态。看清每一次回答的过程,才能更有把握地优化体验、控制成本,并在问题出现时快速找到可验证的行动方向。
扫描二维码,即刻下载精彩演讲资料。